
共计 1861 个字符,预计需要花费 5 分钟才能阅读完成。

核心概念:skill 与 tool 的架构定位
在 openclaw 框架中,skill 和 tool 是两种核心抽象,它们共同构成了系统的可扩展基础。理解它们的区别和联系是高效使用 openclaw 的关键。
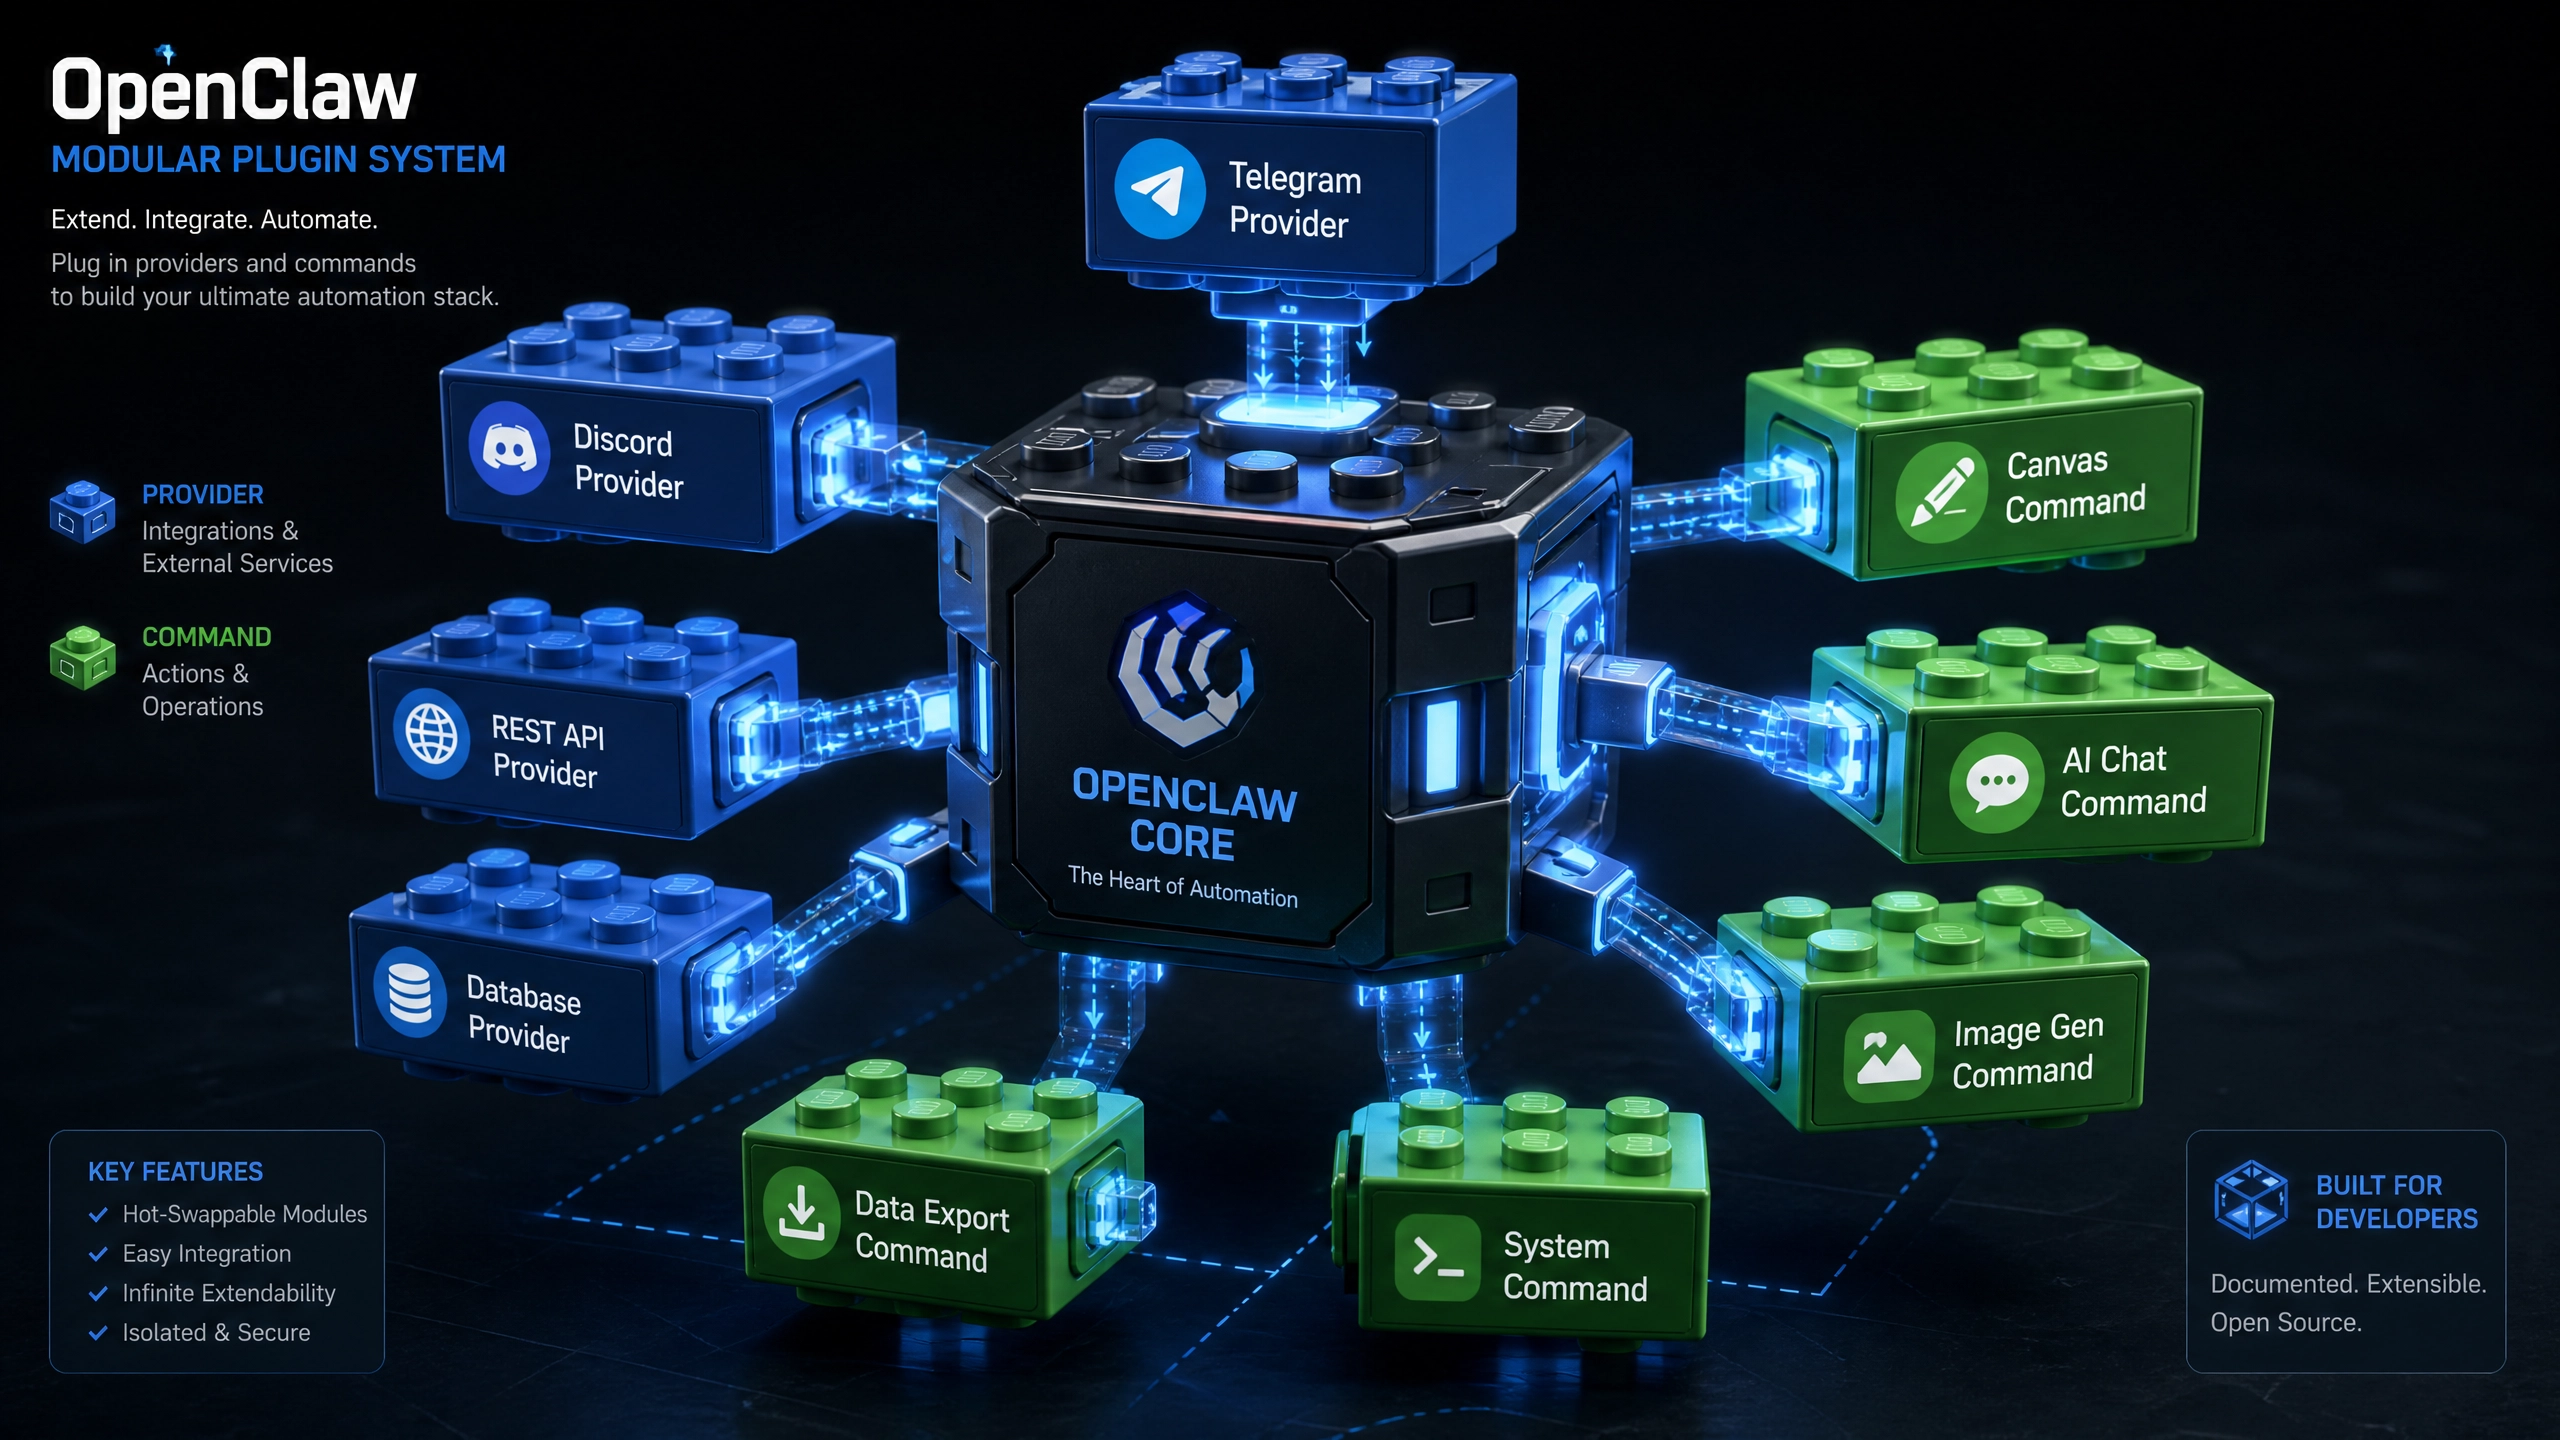
- skill 的定义 :
- 代表系统的基础能力单元,通常是原子化的功能模块
- 具有明确的输入输出接口规范
-
示例:图像识别、文本分类等基础 AI 能力
-
tool 的本质 :
- 由多个 skill 组合而成的复合操作单元
- 包含业务流程编排逻辑
-
示例:电商推荐系统可能组合用户画像、商品匹配等 skill
-
关键区别 :
- 抽象层级:skill 是底层能力,tool 是高层应用
- 复用范围:skill 跨 tool 复用,tool 通常特定场景专用
- 开发方式:skill 需要注册到中央仓库,tool 可动态组合
开发者常见痛点分析
实际开发中,skill 和 tool 的使用往往会遇到一些典型问题:
- 性能瓶颈 :
- 未经优化的 skill 链式调用会导致延迟叠加
-
示例:三个各需 100ms 的 skill 串联就会产生至少 300ms 延迟
-
资源竞争 :
- 多个 tool 共享同一 skill 时可能引发资源争用
-
典型表现:GPU 内存不足导致的 OOM 错误
-
版本管理混乱 :
- skill 升级后未及时通知依赖的 tool
-
结果:生产环境出现接口不兼容问题
-
监控盲区 :
- 缺乏细粒度的 skill 级性能指标
- 故障排查时难以定位具体问题节点
技术实现:交互机制详解
架构设计原理
openclaw 采用星型拓扑结构管理 skill 和 tool 的交互:
graph LR
    T[Tool] -->| 请求 | C[Central Broker]
    C -->| 路由 | S1[Skill1]
    C -->| 路由 | S2[Skill2]
    S1 -->| 响应 | C
    S2 -->| 响应 | C
    C -->| 聚合 | T
典型调用示例(Python)
# Skill 基础类示例
class ImageProcessingSkill:
    def __init__(self):
        self.skill_name = "image_processor"

    def execute(self, input_data):
        """
        输入: base64 编码的图片
        输出: 处理后的特征向量
        """
        # 实际的图像处理逻辑
        return feature_vector

# Tool 组合示例
class ProductRecommendationTool:
    def __init__(self):
        self.required_skills = ["image_processor", "user_profiler"]

    def run(self, user_input):
        # 通过 broker 调用 skill
        img_features = broker.call("image_processor", user_input.image)
        user_profile = broker.call("user_profiler", user_input.metadata)

        # 业务逻辑处理
        return generate_recommendations(img_features, user_profile)
性能优化策略
经过生产验证的有效优化方法:
- Skill 预热 :
- 系统启动时预加载高频使用 skill 的模型
-
效果:降低首次调用的冷启动延迟
-
结果缓存 :
- 对确定性 skill 的输出实施 TTL 缓存
-
实现参考:
@lru_cache(maxsize=1000) def deterministic_skill(input): # 保证相同输入总是相同输出的处理逻辑 return processed_result -
批量处理模式 :
- 改造 skill 接口支持 batch 处理
- 收益:减少 IO 和上下文切换开销
生产环境最佳实践
总结自多个实际项目的经验教训:
- 版本隔离 :
- 为每个 skill 维护独立的虚拟环境
-
避免 python 包冲突
-
熔断机制 :
- 为 skill 设置超时和错误率阈值
-
异常时自动降级
-
依赖声明 :
- 在 skill 元数据中明确声明硬件需求
-
示例:
requires_gpu: true -
测试策略 :
- 对 tool 进行 skill 模拟测试
-
确保单个 skill 故障不影响整体可用性
-
文档规范 :
- 为每个 skill 提供标准的接口文档
- 包含输入输出示例和性能基准
值得深入的方向
- 智能路由研究 :
- 基于负载预测的 skill 动态调度
-
考虑地理位置、硬件特性等因素
-
联邦学习集成 :
- 跨节点的 skill 协同训练
- 在隐私保护前提下提升模型效果
动手实践建议
建议从简单的文本处理场景开始体验:
- 实现一个基础的文本清洗 skill(如去除特殊字符)
- 创建组合清洗 + 分词 + 情感分析的 tool
- 使用 mock 数据测试完整链路
通过这个微型 demo,可以直观感受 skill 的原子性和 tool 的编排价值。后续再逐步扩展到更复杂的业务场景。
正文完


