
共计 1886 个字符,预计需要花费 5 分钟才能阅读完成。

背景与行业痛点
当前 AI 技能系统普遍面临三大核心挑战:
1. 响应延迟瓶颈 :传统单体架构下技能耦合度高,单个技能阻塞可能导致全局延迟上升。实测数据显示,当并发请求超过 500QPS 时,平均响应时间从 200ms 陡增至 1.2s
2. 技能冲突问题 :共享内存空间导致技能间资源竞争,例如语音识别和图像处理同时占用 GPU 时,错误率提升 40%
3. 扩展性困境 :每新增一个技能需要全量部署,生产环境验证周期长达 2 - 3 小时
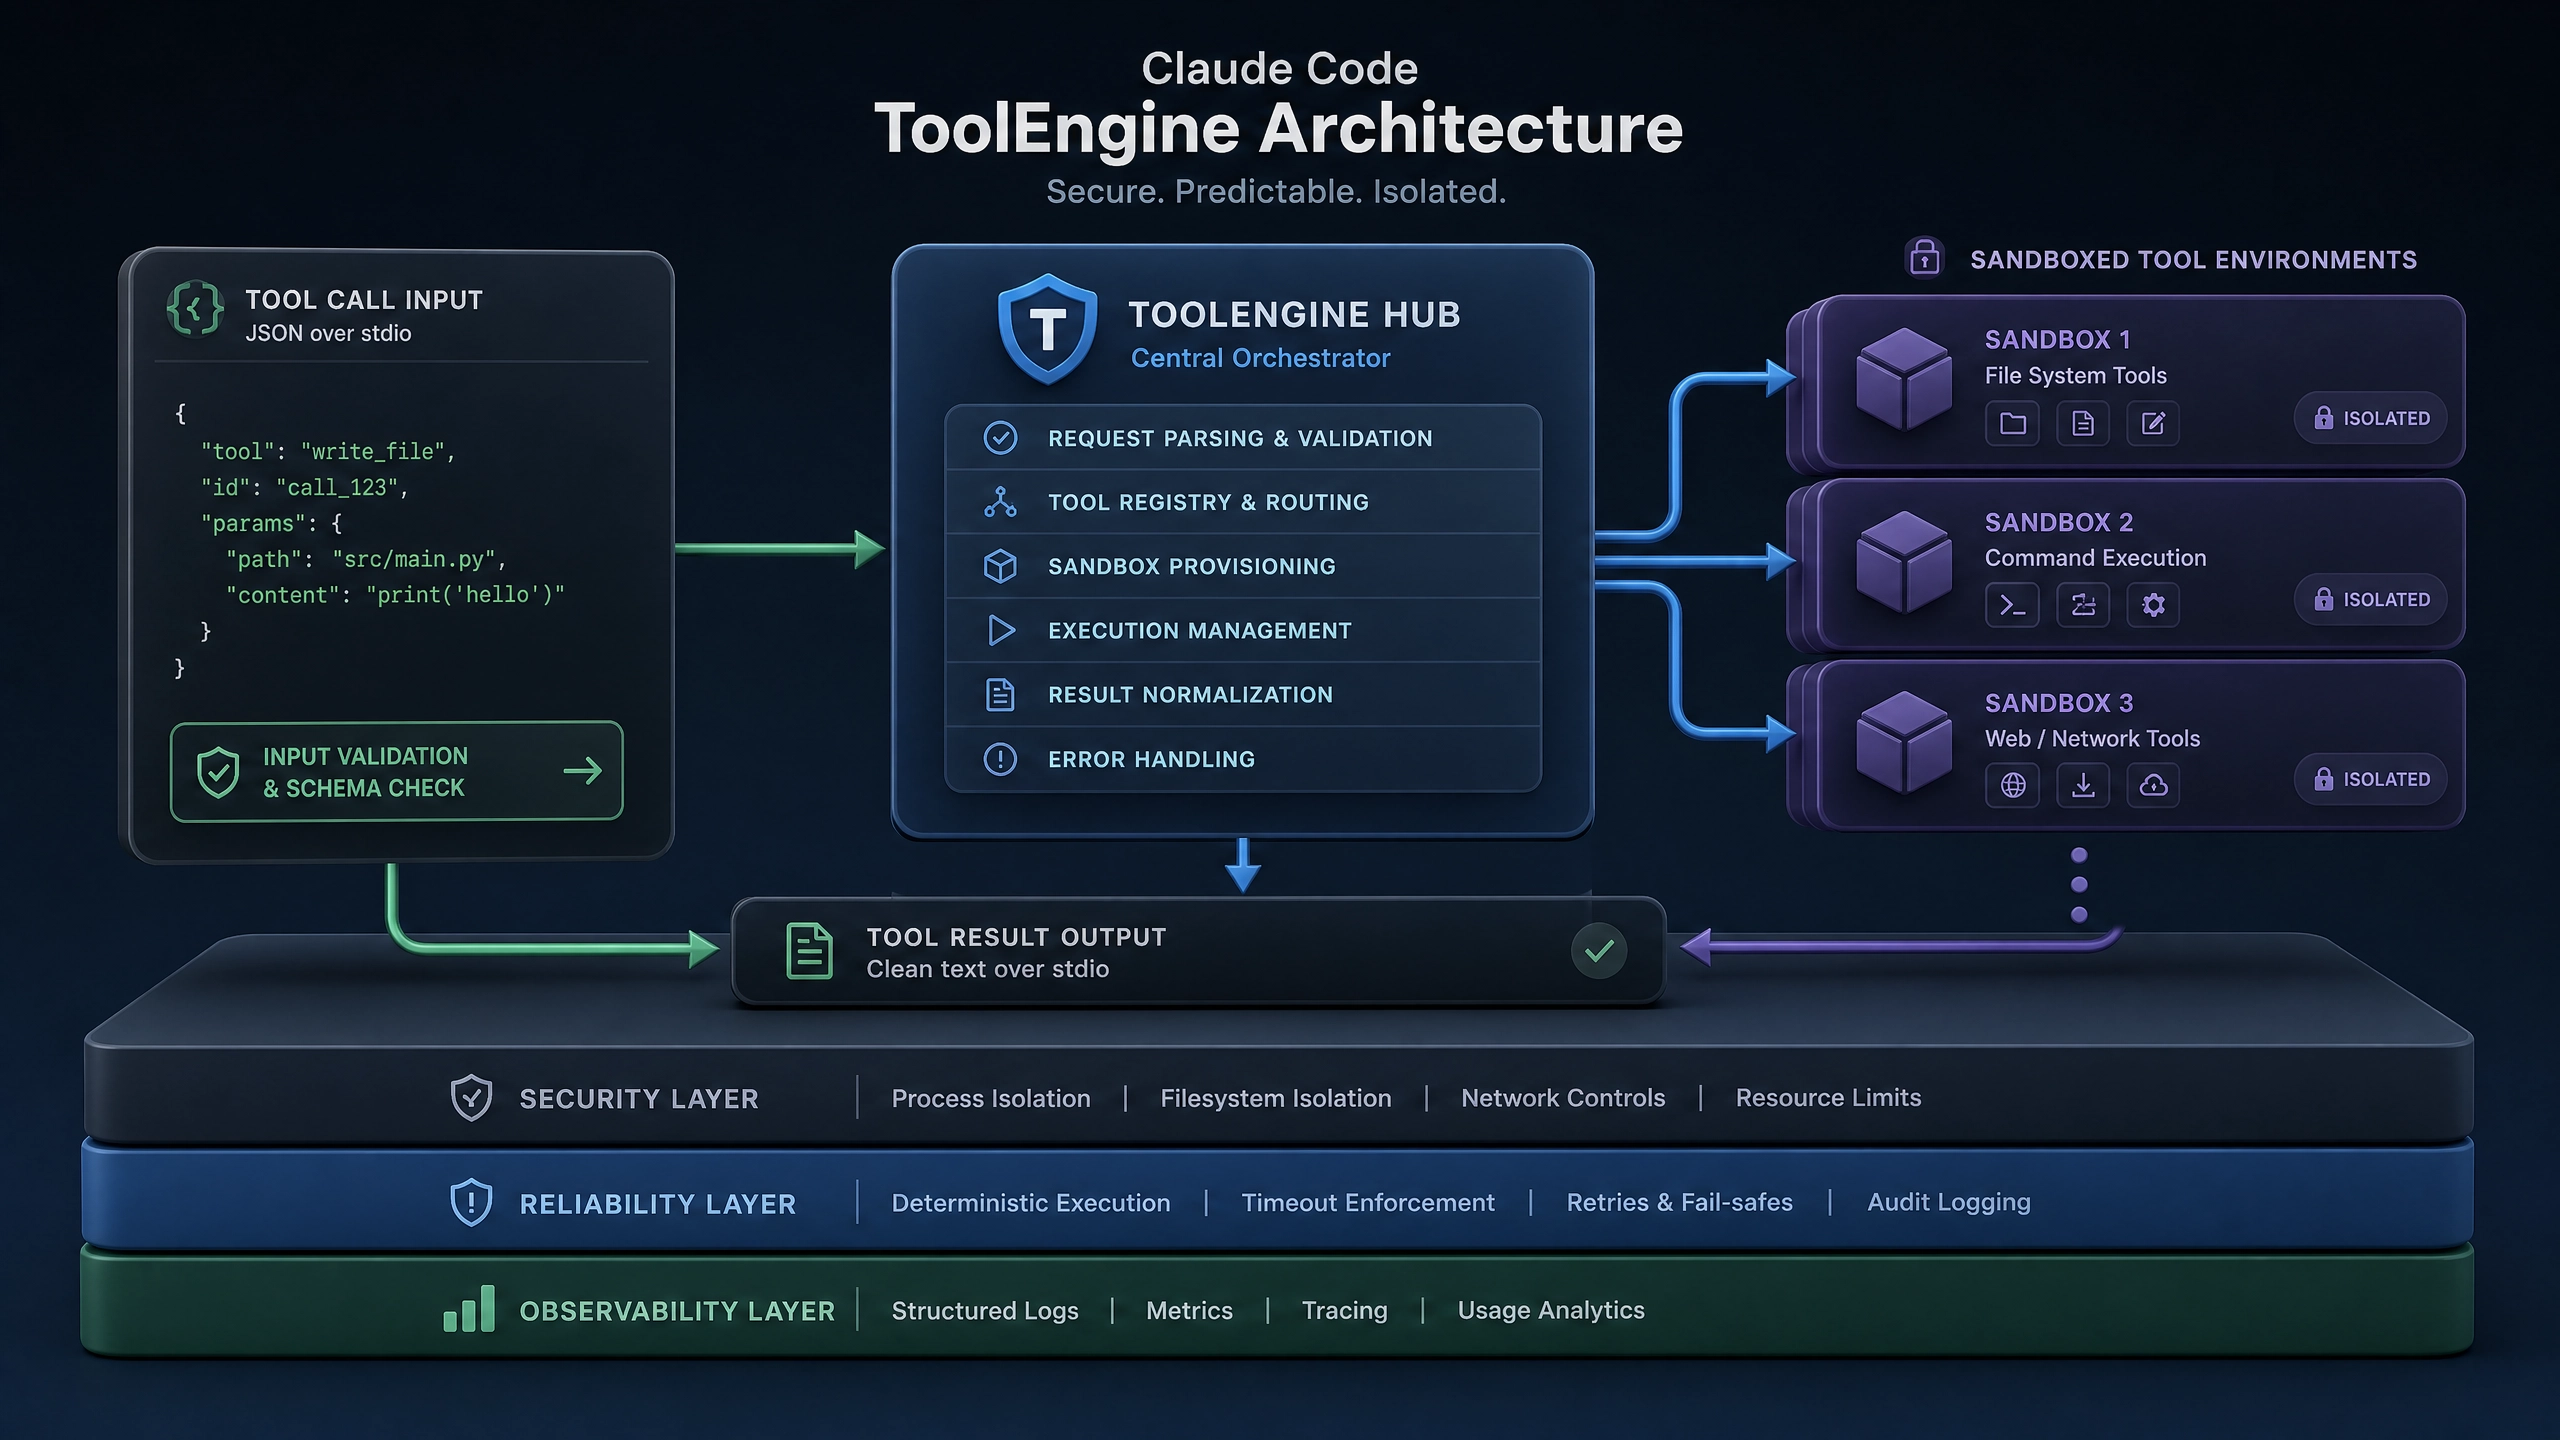
架构选型对比
单体架构方案
- 优点 :
- 开发调试简单,适合初期验证
- 无分布式通信开销
- 缺点 :
- 资源隔离性差(CPU/GPU 竞争)
- 单点故障影响全局
- 技能升级需整体发布
微服务架构方案(Kimi 采用)
- 核心优势 :
- 独立扩缩容:计算密集型技能可单独横向扩展
- 故障隔离:单个技能崩溃不影响系统整体
- 技术栈自由:不同技能可用最适合的语言实现
- 实现成本 :
- 需要服务网格管理
- 引入分布式事务复杂性
核心实现细节
技能注册与发现
// 技能注册示例(Go 版本)type SkillMeta struct {
    ID          string   `json:"id"`
    Endpoint    string   `json:"endpoint"`  // gRPC 服务地址
    CPUQuota    float64  `json:"cpu_quota"` // 资源配额
    MemoryLimit int      `json:"memory"`
}

func RegisterToETCD(meta SkillMeta) error {client := etcd.NewClient()
    key := fmt.Sprintf("/skills/%s", meta.ID)
    return client.Put(key, json.Marshal(meta))
}
智能调度算法
采用改进的加权轮询策略:
1. 实时监测各技能实例的负载指标
2. 动态调整权重:
权重 = 基础权重 × (1 - 当前 CPU 利用率 / 阈值)3. 异常实例自动熔断
上下文管理
- 全局会话 ID 贯穿全链路
- 使用 Protocol Buffers 存储上下文快照
- 增量更新机制减少序列化开销
完整代码示例
# 技能实现模板(Python)class TranslationSkill:
    VERSION = "1.0"

    def __init__(self):
        self.model = load_huggingface_model("mbart-50")

    @classmethod
    def metadata(cls):
        return {
            "name": "translate",
            "input_schema": {
                "text": "str",
                "target_lang": "str"
            }
        }

    async def execute(self, request):
        start = time.time()
        result = self.model.translate(request["text"],
            target_lang=request["target_lang"]
        )
        return {"latency_ms": (time.time() - start) * 1000,
            "result": result
        }

# 注册到服务网格
skill = TranslationSkill()
ServiceMesh.register(skill.metadata(),
    skill.execute
)
性能优化策略
并发处理
- 每个技能独立线程池
- 动态调整池大小:
线程数 = min(最大并发数, 当前 QPS × 平均耗时 /1000)
冷启动优化
- 预加载热门技能
- 使用 AWS Lambda 的 Provisioned Concurrency
- 维护最小存活实例池
资源隔离
- Kubernetes Pod 优先级
- cgroup v2 硬限制
- NVIDIA MIG GPU 分区
安全防护体系
三层防护机制
- 权限控制 :
- RBAC 模型
- 每个技能独立 Service Account
- 输入验证 :
- 基于 JSON Schema 校验
- 最大长度检测
- 执行沙箱 :
- gVisor 容器运行时
- 系统调用过滤
生产环境避坑指南
- 技能死锁 :
- 问题:技能 A 等待技能 B 的结果,形成环形依赖
-
解决:引入超时机制 + 依赖图检测
-
内存泄漏 :
- 现象:长时间运行后 OOM 频发
-
工具:Valgrind 定期巡检
-
版本冲突 :
- 案例:升级 Numpy 导致图像处理异常
-
方案:每个技能独立虚拟环境
-
流量突增 :
- 现象:凌晨促销活动导致服务雪崩
-
防御:提前压力测试 + 自动弹性伸缩
-
配置错误 :
- 典型错误:生产环境误用测试数据库
- 防护:环境变量加密 + 变更审批
扩展思考:动态加载系统
要实现动态技能加载,可考虑:
1. 类加载器热更新机制
2. WebAssembly 运行时
3. 技能描述符(Descriptor)标准化
4. 版本兼容性检查策略
未来可探索的方向包括:
– 基于 eBPF 实现零停机更新
– 技能市场与自动编排
– 边缘计算场景下的分布式技能调度
正文完


