
共计 4006 个字符,预计需要花费 11 分钟才能阅读完成。

技术背景:Agent Skill 的价值定位
Agent Skill 是大模型应用中实现功能模块化的关键技术。通过将特定能力封装为独立技能(如天气查询、数学计算、文档生成),开发者可以像搭积木一样组合这些技能,构建出功能丰富的智能体应用。其核心价值体现在三个方面:
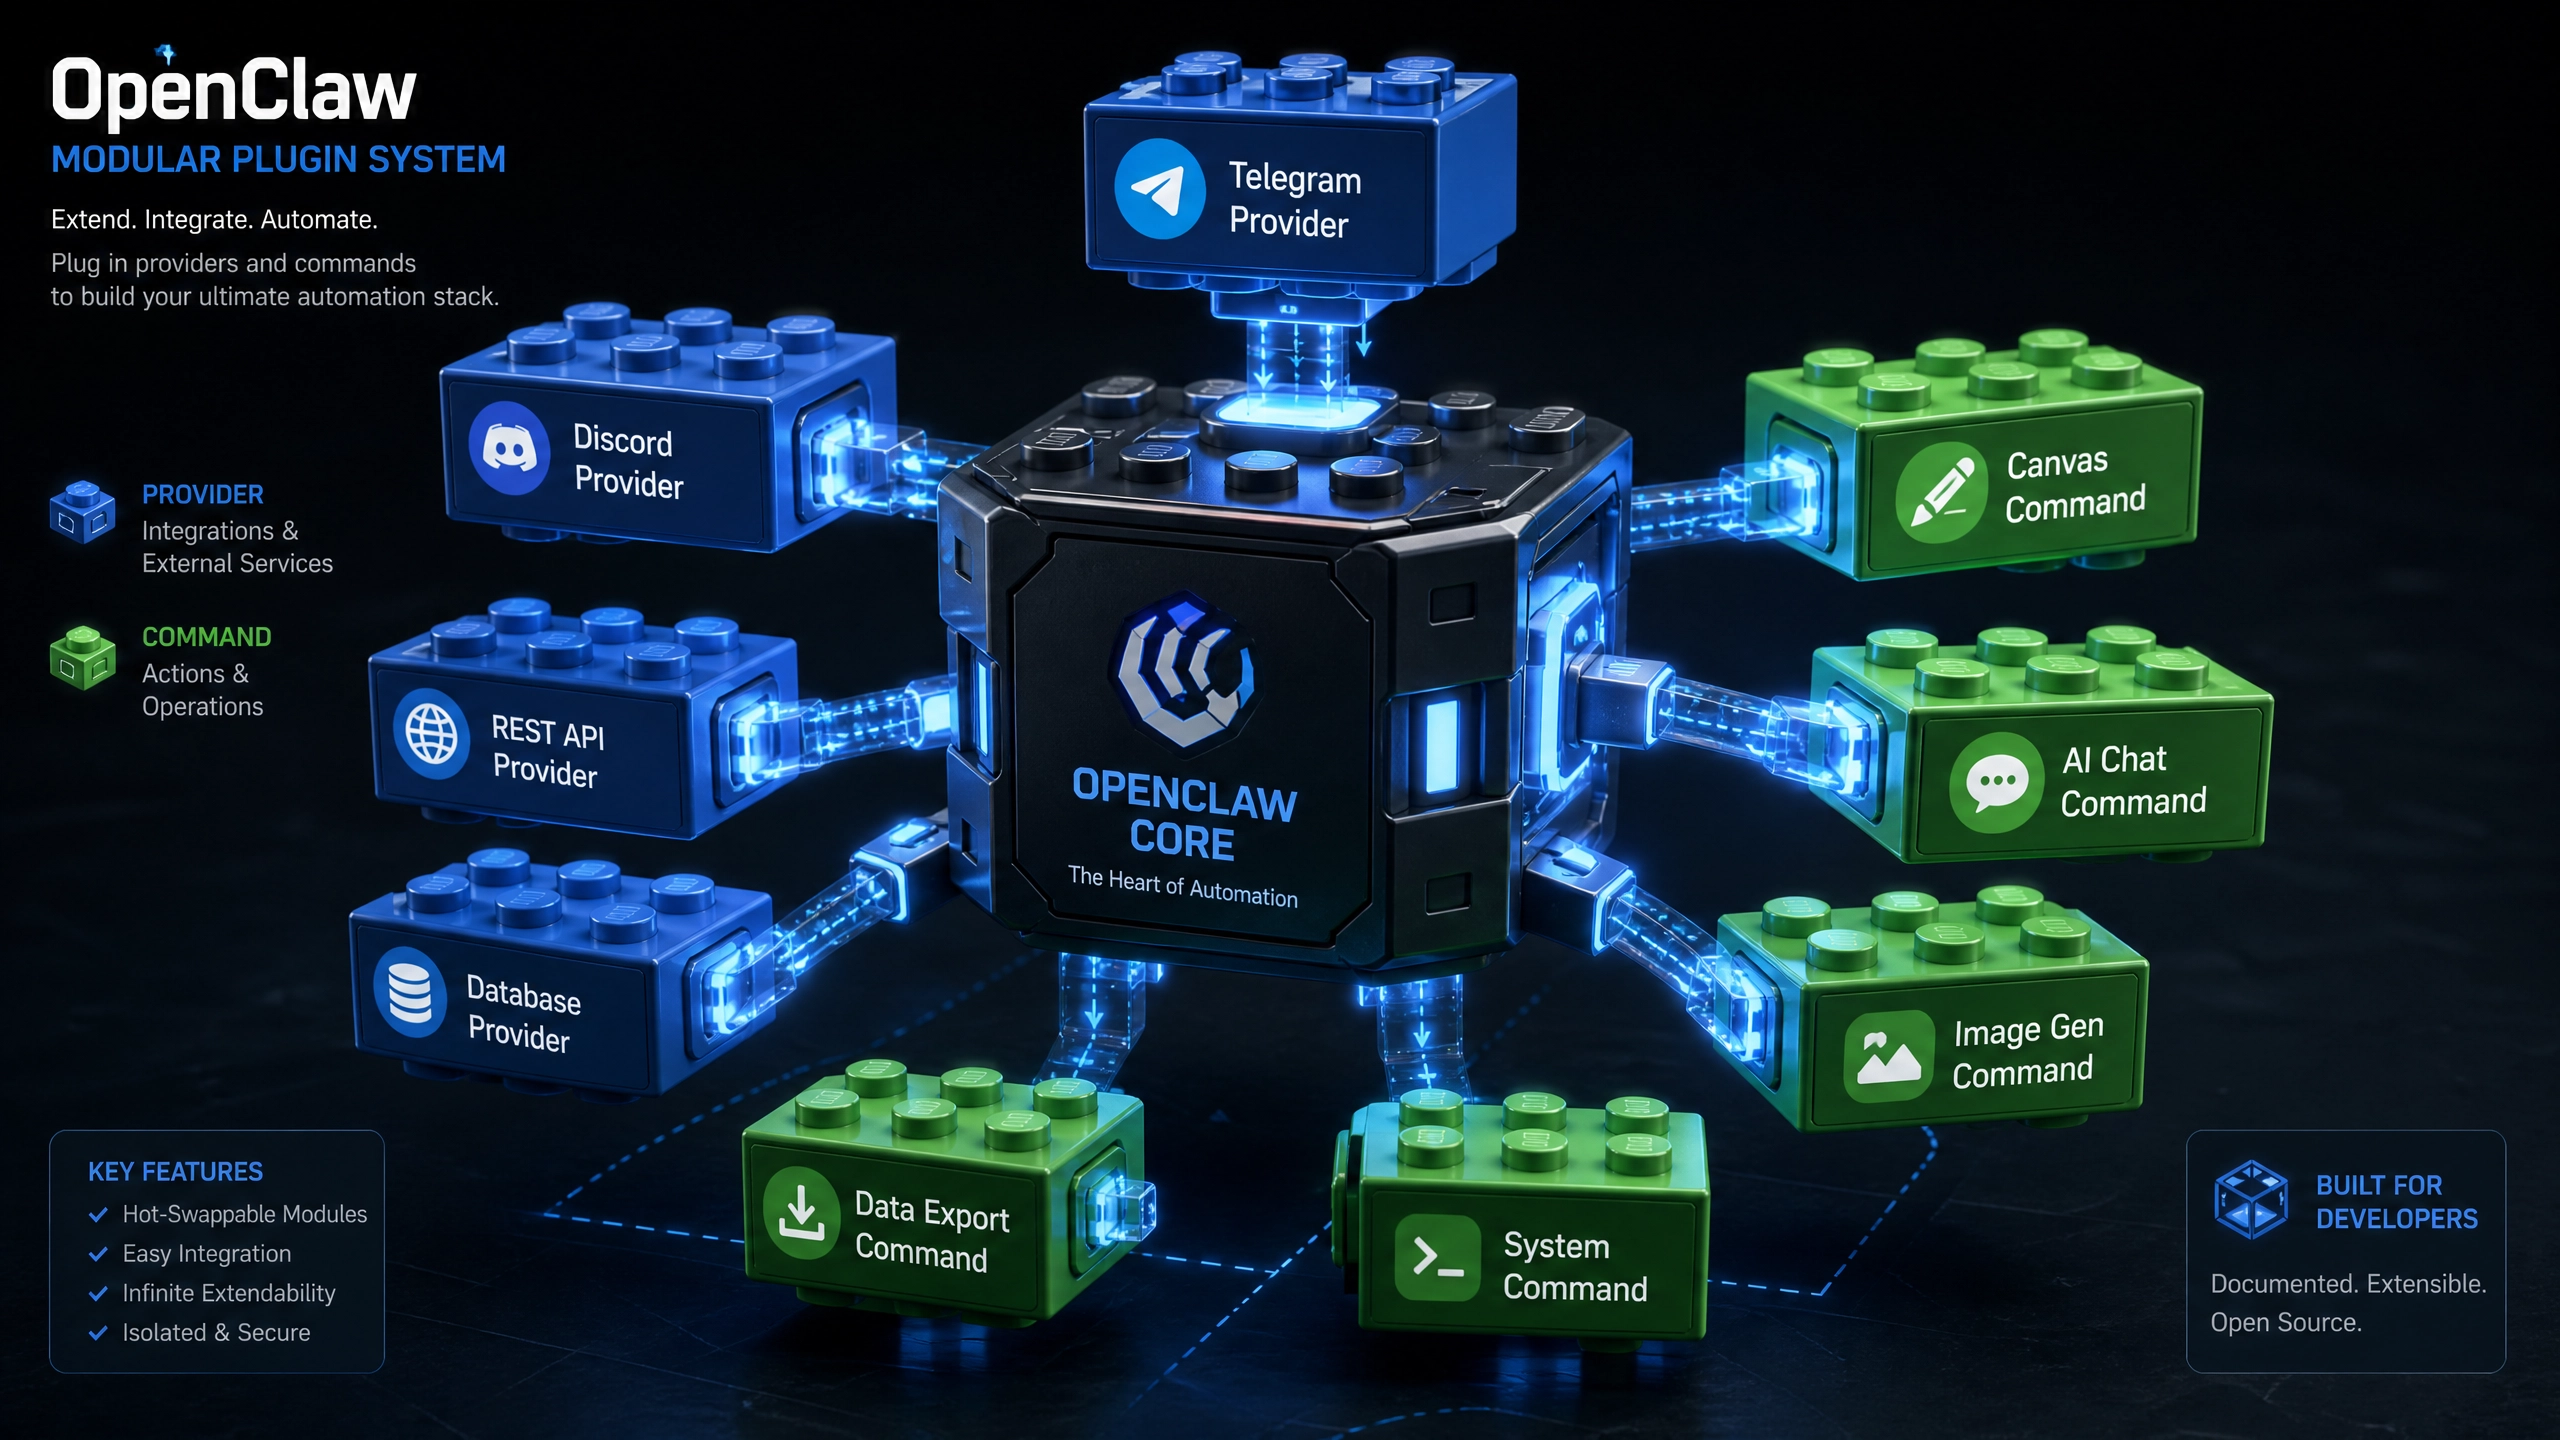
- 功能解耦 :每个 Skill 只需关注单一功能,降低系统复杂度
- 动态扩展 :新增能力无需修改核心架构,通过注册机制即可接入
- 复用共享 :通用技能可跨项目复用,减少重复开发
核心挑战与解决思路
1. 技能编排难题
当用户请求涉及多个技能时(如 ” 总结上周销售数据并生成图表 ”),需要解决:
- 技能依赖关系解析
- 执行顺序动态调整
- 中间结果传递机制
2. 上下文保持
跨技能对话需要维护的上下文包括:
- 用户意图历史
- 当前会话状态
- 已执行技能的输出
3. 性能开销控制
大模型调用成本主要来自:
- 长上下文带来的 token 消耗
- 频繁的技能切换开销
- 复杂推理的响应延迟
架构设计(图示说明)
flowchart TB
    subgraph 用户端
        A[用户请求] --> B[意图识别]
    end

    subgraph 技能引擎
        B --> C{技能路由}
        C -->| 匹配 | D[技能 A]
        C -->| 匹配 | E[技能 B]
        D --> F[结果聚合]
        E --> F
    end

    subgraph 支撑系统
        G[技能注册中心]
        H[上下文管理]
        I[性能监控]
    end
关键组件说明:
- 技能注册中心 :维护技能元信息(名称、输入输出格式、依赖关系)
- 上下文管理器 :采用分层存储策略(会话级 / 用户级 / 全局)
- 性能监控器 :实时跟踪技能执行耗时和资源消耗
代码实现:Python 核心示例
技能基类定义
from typing import Protocol, Any, Dict
from dataclasses import dataclass

class SkillProtocol(Protocol):
    """技能接口标准定义"""
    name: str

    def execute(self, context: Dict[str, Any]) -> Dict[str, Any]:
        """
        执行技能核心逻辑
        :param context: 包含输入参数和会话上下文
        :return: 标准化输出字典
        """
        ...

@dataclass
class SkillMetadata:
    """技能元数据"""
    name: str
    description: str
    input_schema: Dict[str, type]
    output_schema: Dict[str, type]
具体技能实现示例(天气查询)
class WeatherSkill(SkillProtocol):
    """天气查询技能实现"""

    def __init__(self):
        self.name = "weather_query"
        self.metadata = SkillMetadata(
            name="weather_query",
            description="查询指定城市天气情况",
            input_schema={"city": str},
            output_schema={"temperature": float, "conditions": str}
        )

    def execute(self, context: Dict[str, Any]) -> Dict[str, Any]:
        city = context.get("city")
        if not city:
            raise ValueError("Missing required parameter: city")

        # 模拟调用天气 API
        return {
            "temperature": 25.5,
            "conditions": "sunny",
            "_metadata": {"source": "mock_data"}
        }
技能路由器实现
class SkillRouter:
    """基于意图的技能路由"""

    def __init__(self):
        self._skills: Dict[str, SkillProtocol] = {}

    def register_skill(self, skill: SkillProtocol) -> None:
        """注册技能实例"""
        if skill.name in self._skills:
            raise ValueError(f"Skill {skill.name} already registered")
        self._skills[skill.name] = skill

    def route(self, intent: str, context: Dict[str, Any]) -> Dict[str, Any]:
        """
        路由到对应技能执行
        :param intent: 识别出的技能名称
        :returns: 标准化技能输出
        """
        skill = self._skills.get(intent)
        if not skill:
            raise KeyError(f"No skill matched for {intent}")

        # 验证输入参数
        self._validate_input(skill, context)

        return skill.execute(context)

    def _validate_input(self, skill: SkillProtocol, context: Dict[str, Any]) -> None:
        """根据元数据校验输入参数"""
        for param, param_type in skill.metadata.input_schema.items():
            if param not in context:
                raise ValueError(f"Missing required parameter: {param}")
            if not isinstance(context[param], param_type):
                raise TypeError(f"Parameter {param} expects {param_type}, got {type(context[param])}"
                )
性能优化实战策略
1. 并发处理模式
from concurrent.futures import ThreadPoolExecutor

class ParallelSkillExecutor:
    """并行执行无依赖关系的技能"""

    def __init__(self, max_workers: int = 4):
        self.executor = ThreadPoolExecutor(max_workers=max_workers)

    def execute_parallel(
        self,
        skills: List[Tuple[SkillProtocol, Dict[str, Any]]]
    ) -> List[Dict[str, Any]]:
        """
        并行执行多个技能
        :param skills: (技能实例, 输入上下文) 元组列表
        :return: 按输入顺序对应的结果列表
        """
        future_to_idx = {self.executor.submit(skill.execute, ctx): idx
            for idx, (skill, ctx) in enumerate(skills)
        }

        results = [None] * len(skills)
        for future in as_completed(future_to_idx):
            idx = future_to_idx[future]
            results[idx] = future.result()

        return results
2. 上下文缓存策略
from datetime import timedelta
from functools import lru_cache

class ContextCache:
    """基于 LRU 的上下文缓存"""

    def __init__(self, maxsize: int = 1000, ttl: int = 300):
        self._cache = lru_cache(maxsize=maxsize)
        self.ttl = timedelta(seconds=ttl)

    def get(self, session_id: str) -> Optional[Dict[str, Any]]:
        """获取缓存上下文"""
        entry = self._cache.get(session_id)
        if entry and datetime.now() - entry["timestamp"] < self.ttl:
            return entry["context"]
        return None

    def set(self, session_id: str, context: Dict[str, Any]) -> None:
        """更新缓存"""
        self._cache[session_id] = {
            "context": context,
            "timestamp": datetime.now()}
安全防护体系
- 输入验证 :
- 所有字符串参数进行 HTML 转义
- 数值类型检查范围边界
-
使用 JSON Schema 严格校验复杂结构
-
权限控制 :
- 基于 RBAC 模型的技能访问控制
- 敏感技能需要二次认证
-
操作日志完整审计
-
沙箱保护 :
- 高风险技能在隔离环境中执行
- 限制系统资源访问
- 超时强制终止机制
避坑指南:生产环境常见问题
- 技能冲突 :
- 现象:多个技能响应同一意图
-
方案:设置技能优先级分数,结合用户反馈动态调整
-
上下文污染 :
- 现象:不同会话的上下文相互干扰
-
方案:严格隔离会话 ID,添加 namespace 前缀
-
大模型幻觉 :
- 现象:错误调用不存在的技能
-
方案:维护技能白名单,添加置信度阈值检测
-
性能雪崩 :
- 现象:高峰时段响应延迟飙升
-
方案:实现熔断降级机制,非核心技能动态关闭
-
技能退化 :
- 现象:长期运行后准确率下降
- 方案:建立自动化测试流水线,定期评估技能效果
扩展与实践建议
- 技能市场 :建立内部技能共享平台,促进资产复用
- 自动编排 :利用大模型自身能力实现动态技能组合
- 效果评估 :构建技能级的 A / B 测试框架
- 生态建设 :制定技能开发规范,提供标准工具链
实际部署时建议从简单场景入手,逐步验证核心机制。初期可重点关注:
- 技能接口的向后兼容性
- 监控指标的全面性
- 回滚机制的可靠性
随着技能数量增长,需特别注意:
- 技能发现效率问题
- 依赖管理的复杂性
- 版本控制的一致性
正文完


